DifyでRAG(検索拡張生成)を使うには、「ナレッジ」に文書を登録し、アプリからそのナレッジを検索させます。質問が届くと、ナレッジから関係する部分(チャンク)が探され、質問と一緒にAIモデルへ渡されます。AIモデルは、学習した知識だけでなく、登録した文書の内容をもとに回答を作ります。
この記事では、RAGの仕組みを、Difyのナレッジの設定項目に沿って説明します。
- 従来型ナレッジベースとAgentナレッジベースの違い
- チャンクのモード、インデックスの方法、埋め込みモデル、検索の方法、リランク、TopK・Scoreしきい値、メタデータ
- 外部ナレッジAPIで自社の検索の仕組みをつなぐ方法
- 回答の精度が低いときに見直す点と、無料プランの上限
内容はDify Cloudの公式ドキュメント(2026年11月時点)に基づきます。画面の名前は公式ドキュメントの日本語版の表記に合わせ、必要に応じて英語版の表記を括弧で添えています。日本語版のドキュメントは自動翻訳のため、実際の画面の表記と違う場合があります。
ナレッジに文書を登録してチャットボットを作るまでの基本の手順は「Difyの使い方」で説明しています。
DifyのRAGの仕組み
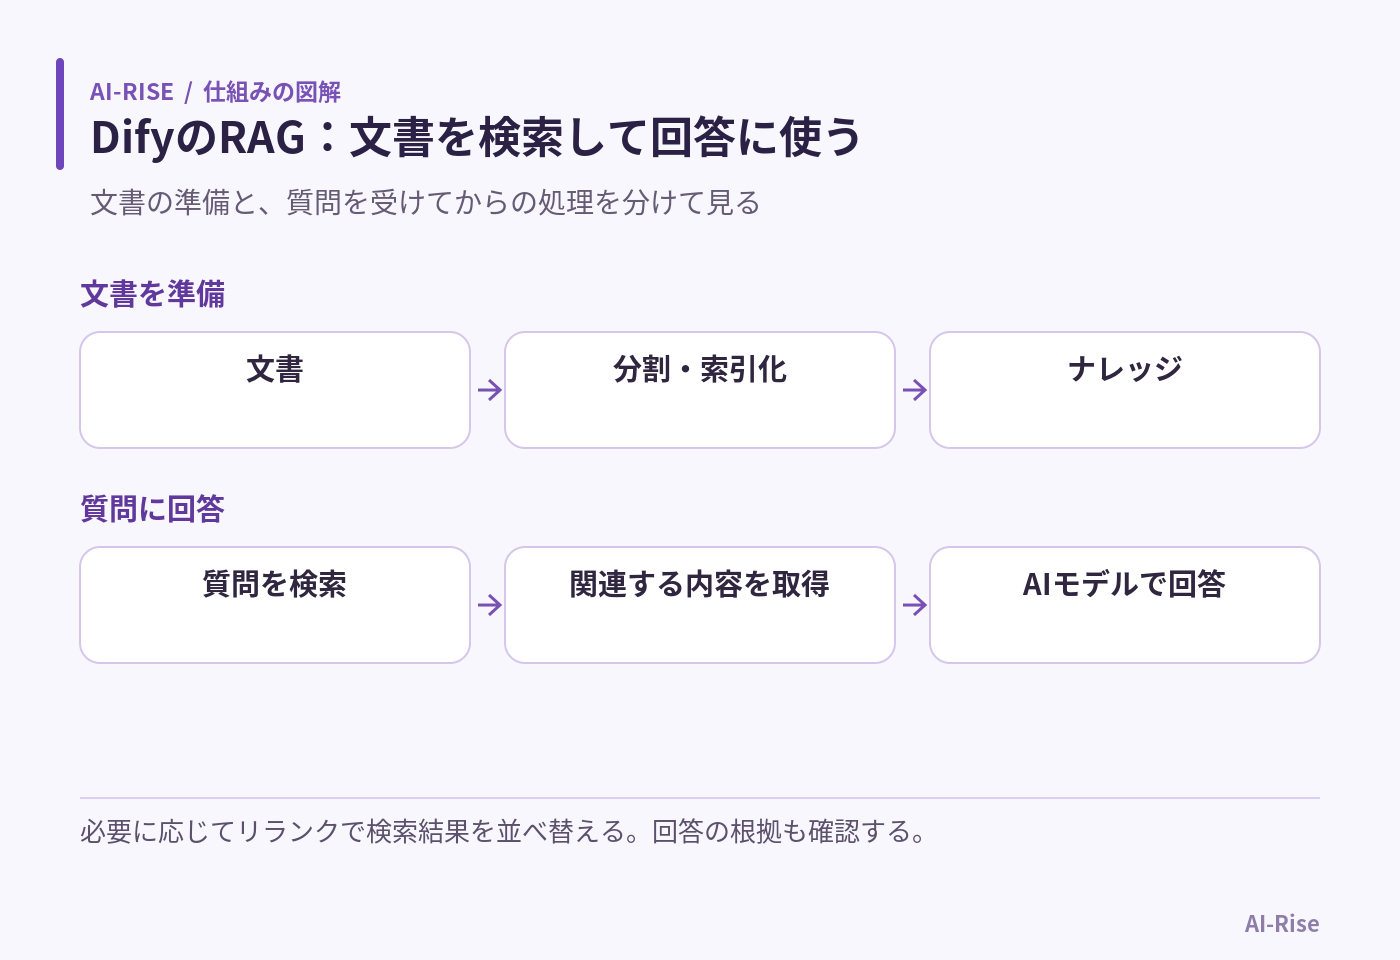
Difyのナレッジは、文書を登録するときと、質問に答えるときの2つの段階で動きます。それぞれの段階に、この記事で説明する設定項目が対応しています。
| 段階 | Difyの中で起きること | 関係する設定 |
|---|---|---|
| 1. 文書を分割する | 登録した文書を、検索しやすい短いまとまり(チャンク)に分ける | チャンクのモード、区切り文字、最大チャンク長 |
| 2. 検索できる形にする | チャンクを数値の並び(ベクトル)やキーワードの索引に変えて保存する | インデックスの方法、埋め込みモデル |
| 3. 質問に近いチャンクを探す | 質問の意味や語句をもとに、関係するチャンクを探す | 検索の方法(ベクトル検索・全文検索・ハイブリッド検索)、メタデータでの絞り込み |
| 4. 結果を並べ替えて絞る | 見つかったチャンクを関係の強い順に並べ、渡す数を決める | リランク、TopK、Scoreしきい値 |
| 5. 回答を作る | 選ばれたチャンクを質問と一緒にAIモデルへ渡し、回答を作る | 知識検索ノード、LLMノードの「コンテキスト」 |
回答が資料と合わないときは、どの段階で問題が起きているかを見ると、直す設定が分かります。見直し方は「回答の精度が低いときの見直し点」の節で説明します。
DifyのRAGで作れるアプリの例
この記事で説明する設定を使うアプリの構成例を、入力・処理・出力で示します。いずれも公式ドキュメントに載っている機能を組み合わせた例です。
| アプリ | 入力 | 処理 | 出力 |
|---|---|---|---|
| 地域ごとの社内規程の質問窓口 | 社員の質問 | 知識検索で、メタデータ(対象の地域)が一致する規程の文書だけを検索し、LLMが回答を作る | その地域の規程にもとづく回答と、参照した文書 |
| 製品マニュアルの問い合わせ対応 | 利用者が書いた症状 | 親子モードで登録したマニュアルを検索する。検索結果が空ならIf-Elseで決まった案内文に分け、あればLLMが回答を作る | 手順の回答。資料に無い質問には問い合わせ先の案内 |
| 自社の検索システムを使うチャットボット | 利用者の質問 | 外部ナレッジAPIでつないだ自社のシステムを検索し、返ってきたチャンクをもとにLLMが回答を作る | 資料をDifyに移さずに作った回答 |
Difyのナレッジベースは2種類ある
2026年11月時点の公式ドキュメントでは、Difyのナレッジベースは「従来型ナレッジベース(Classic Knowledge Base)」と「Agentナレッジベース(Agent Knowledge Base)」の2種類です。Agentナレッジベースはベータ版です。
| 項目 | 従来型ナレッジベース | Agentナレッジベース(ベータ版) |
|---|---|---|
| 使えるアプリ | チャットボット、テキストジェネレーター、従来のAgent、ワークフロー、チャットフロー | ワークフロー、チャットフロー、新しいAgent |
| 自分で決める設定 | モデル、チャンクのモードと長さ、インデックスの方法、検索の方法、TopK、Scoreしきい値 | モデル、検索の深度、TopK、Scoreしきい値 |
| 文書の分割 | 設定した区切り文字と長さで分割する | 推論モデルが文書を読み、意味のまとまりで分割・要約する |
| 文書の取り込み元 | ファイルのアップロード、Webサイト、Notion、ナレッジパイプライン経由のデータソース、外部ナレッジベース | ファイルのアップロード、Webサイト、オンラインドキュメント、オンラインドライブ |
| 1ファイルの大きさ | Sandboxは15MBまで、ProfessionalとTeamは50MBまで | すべてのプランで15MBまで |
| 内容の更新 | NotionとWebサイトの文書は手動で同期する | 取り込み元ごとに、設定した間隔で同期する |
| 検索結果の確認 | 検索テスト | 検索テストに加え、評価用の基準質問、評価、問題ケース |
公式ドキュメントは、新しく作る場合はAgentナレッジベースから始めることをすすめています。チャットボットなどワークフロー以外のアプリで使う場合、分割や検索の方法を自分で決めたい場合、自社で運用している検索の仕組みにつなぐ場合、15MBを超えるファイルを使う場合は、従来型を選びます。
多くの従来型ナレッジベースは、あとからAgentナレッジベースにアップグレードできます。逆に、Agentナレッジベースを従来型へ変えることはできません。外部ナレッジベースと、ナレッジパイプラインで作ったナレッジベースはアップグレードの対象外です。
Difyの従来型ナレッジベースの設定項目
従来型ナレッジベースでは、文書をアップロードしたあと、分割・インデックス・検索の方法を自分で選びます。それぞれの設定の意味と、あとから変えられるかどうかを順に説明します。
チャンクのモード(汎用モード・親子モード)
チャンクの分け方は、「区切り文字」と「最大チャンク長」で決まります。区切り文字は、たとえば\n\nなら段落ごと、\nなら行ごとに分けます。区切り文字そのものは分割のときに消えます。段落の改行など、区切りとして使う文字を指定し、本文として残したい文字列は指定しないようにします。最大チャンク長を超える部分は、区切り文字に関係なく分割されます。
| 項目 | 汎用モード | 親子モード |
|---|---|---|
| 分け方 | すべてのチャンクを同じ設定で分ける。隣り合うチャンクの重なり(チャンクのオーバーラップ)も指定できる | 大きな「親チャンク」と、その中の小さな「子チャンク」の2段階に分ける。親は段落ごとか文書全体 |
| 検索で返すもの | 一致したチャンクをそのまま返す | 子チャンクで質問と照合し、一致したら親チャンク全体を返す |
| 使えるインデックス | 高品質・エコノミー | 高品質のみ |
| 向いている文書 | 用語集やFAQのように、1項目で意味が完結する文書 | 技術マニュアルや論文のように、前後の文脈が必要な文書 |
親子モードで親を「全文」にした場合、処理されるのは文書の最初の10,000トークンまでで、それを超える部分は切り捨てられます。分割の前に、連続する空白・改行・タブをまとめたり、URLとメールアドレスを削除したりする前処理も選べます。
チャンクのモードは、ナレッジベースを作ったあとに変更できません。区切り文字や最大チャンク長は、あとからでも変えられます。
インデックスの方法と埋め込みモデル
| 項目 | 高品質(High Quality) | エコノミー(Economical) |
|---|---|---|
| 仕組み | 埋め込みモデル(Embedding Model)でチャンクをベクトルに変え、意味の近さで探せるようにする | チャンクごとに10個のキーワードで探す。トークンを使わない |
| 選べる検索の方法 | ベクトル検索・全文検索・ハイブリッド検索 | キーワードの索引(転置インデックス)のみ。設定はTopKだけ |
| 精度 | 言い換えや別の言語の質問にも対応しやすい | 公式ドキュメントでは、検索の精度が下がるとされている |
| あとからの変更 | エコノミーへは変更できない | ナレッジの設定画面で高品質へ変更できる |
高品質で作ったベクトルは、ワークスペースのナレッジの保存容量に数えられます。埋め込みモデルは、ナレッジの設定画面で変更できますが、変更するとすべてのチャンクのベクトルが作り直されます。画像に対応した埋め込みモデル(Visionの表示があるもの)を選ぶと、文書から取り出した画像も検索の対象になります。標準で画像を取り出せるのは、DOCX・XLSXに埋め込まれた2MB未満の画像などで、PDFの中の画像を取り出すにはナレッジパイプラインで文書を処理するプラグインを使います。
検索の方法(ベクトル検索・全文検索・ハイブリッド検索)
インデックスが高品質の場合、検索の方法を3つから選びます。
- ベクトル検索:質問もベクトルに変え、意味の近いチャンクを探す。資料と違う言葉で質問されたときや、別の言語で質問されたときにも見つけやすい
- 全文検索:文書のすべての語句を索引にして、質問の語句を含むチャンクを探す。製品の型番や社内の用語など、正確な言葉で探す場合に向く
- ハイブリッド検索:ベクトル検索と全文検索を同時に行い、両方の結果から選ぶ。「重み付け設定」で意味(セマンティック)とキーワードの比率を調整するか、リランクモデルで並べ替える
重み付け設定は、意味の値を1にするとベクトル検索だけ、キーワードの値を1にすると全文検索だけになります。実際の質問の傾向に合わせて、その間の比率に調整することもできます。
リランク(Rerankモデル)
リランクは、検索で見つかったチャンクを、外部のRerankモデルで質問との関係の強さを計算し直し、並べ替える機能です。初期状態ではオフです。使う場合は、先に「統合」→「モデルプロバイダー」でRerankモデルの提供元を設定します。
公式ドキュメントによると、リランクは、意味と語句の両方で探す必要がある複雑な資料や、複数の言語の資料が返ってくる場合に向いています。その代わり、Rerankモデルの利用料がかかります。重み付け設定は外部のモデルを使わないため、追加の費用はかかりません。画像に対応した埋め込みモデルを使う場合、Rerankモデルも画像に対応したものを選ばないと、画像は並べ替えと検索結果から外れます。
TopKとScoreしきい値
- TopK:AIモデルに渡すチャンクの最大数。初期値は3。増やすと参考にする情報は増えますが、関係の薄いチャンクも混ざりやすくなります
- Scoreしきい値:チャンクを取り出すのに必要な類似度の下限。初期値は0.5。上げるとよく一致するものだけが残り、下げると幅広く取り出します
なお、公式ドキュメントのベクトル検索と全文検索の説明には、「TopKとScoreの設定はリランクの段階でだけ有効で、適用するにはRerankモデルを追加して有効にする必要がある」という注記があります。リランクを使わずに値を変える場合は、次の節で説明する検索テストで結果が変わるかを確認してください。
メタデータで検索する文書を絞る
メタデータは、文書に付けるラベルです。たとえば「部署」「対象の地域」「改訂日」のような項目を文書ごとに付けておくと、検索の対象をその条件に合う文書だけに絞れます。地域ごとの規程が1つのナレッジベースに入っている場合に、別の地域の規程から答えてしまうことを防ぐ、という使い方が公式ドキュメントで紹介されています。
- 項目の種類:文字列・数値・時間の3つ。作ったあとは項目名だけ変更でき、種類は変えられない
- 組み込みのメタデータ:文書名、アップロードした人、アップロード日、最終更新日、取り込み元。初期状態はオフで、有効にすると自動で値が入る
- 値の付け方:文書の詳細ページの「ラベリングを開始」で1件ずつ、または文書の一覧で複数選んでまとめて付ける
- 絞り込みの設定:知識検索ノードの「メタデータフィルタリング」で、手動モード(条件を自分で指定)か自動モード(AIモデルが質問から条件を作る)を選ぶ
絞り込みの条件は、大文字と小文字を区別して照合されます。公式ドキュメントでは、自動モードは条件を作れなかったときに絞り込みなしで検索するため、必ず絞り込みたい場合は手動モードを使うよう案内されています。
アプリからDifyのナレッジを検索する設定
ワークフローとチャットフローでは、「知識検索(Knowledge Retrieval)」ノードでナレッジを検索します。チャットボットなどの基本のアプリでは、「コンテキスト」にナレッジベースを追加します。知識検索ノードでは、次の3つを指定します。
- 何を探すか:「クエリテキスト」に、利用者の質問などの文字列の変数を選ぶ
- どこを探すか:検索するナレッジベースを1つ以上追加する
- 結果をどう扱うか:ノードの「検索設定」で、並べ替えの方法(重み付けかRerankモデル)、TopK、Scoreしきい値を決める
検索の設定は、ナレッジベース側とノード側の2か所にあります。公式ドキュメントでは、ナレッジベースの設定で最初の候補が決まり、ノードの設定でさらに並べ替えたり絞ったりする、2段階のふるいとして説明されています。複数のナレッジベースを追加すると、すべてを同時に検索してから結果をまとめます。重み付けで並べ替えられるのは、追加したナレッジベースがすべて高品質のインデックスの場合だけです。
検索の結果はresultという変数に入ります。LLMノードの「コンテキスト」にこのresultを選び、指示文の中でコンテキストを参照すると、取り出した資料をもとに回答させられます。ユーザー入力・知識検索・LLM・回答の4つのノードをつなぐ手順は「Difyの使い方」の記事で説明しています。
外部ナレッジAPIで自社の検索の仕組みをつなぐ
自社で運用しているRAGの仕組みや、AWSのBedrockなど外部のナレッジサービスに資料がある場合は、資料をDifyへ移さずに、外部ナレッジベースとしてつなげます。Difyは検索の要求を送って結果を受け取るだけで、外部の資料を変更・管理することはありません。公式ドキュメントの手順は次の3段階です。
- 検索用のAPIを用意する:公式の「外部ナレッジAPI」の仕様に合わせて、検索の要求を受け取り、一致したチャンクと類似度を返すAPIを作る
- APIをDifyに登録する:「ナレッジ」の右上の「外部ナレッジベース API」→「外部ナレッジベース API を追加」で、名前・APIエンドポイント・APIキーを入力する。保存するとDifyがテストの要求を送って接続を確認する
- 外部ナレッジベースを作る:「ナレッジ」→「外部ナレッジベースに接続」で、登録したAPIと、外部の側でナレッジを見分けるID(外部ナレッジベース ID)、TopK・Scoreしきい値を指定する
Difyは、登録したエンドポイントの末尾に/retrievalを付けてPOSTで要求を送り、APIキーはAuthorization: Bearerのヘッダーで渡します。要求には、ナレッジのID(knowledge_id)、質問(query)、件数としきい値(retrieval_setting)が入ります。
{
    "knowledge_id": "your-knowledge-id",
    "query": "What is Dify?",
    "retrieval_setting": {
        "top_k": 3,
        "score_threshold": 0.5
    }
}APIは、recordsの配列で結果を返します。1件ごとに、本文(content)、類似度(score、0〜1)、文書の題名(title)、任意の付加情報(metadata)を入れます。公式ドキュメントでは、metadataをnullにすると検索の処理でエラーになるため、空の場合も{}を返すよう注意されています。
外部ナレッジベースのAPIとIDは、作ったあとに変更できません。別のAPIや資料に切り替える場合は、外部ナレッジベースを作り直します。LlamaCloudを使う場合は、APIを自作せずに公式のLlamaCloudプラグインを使う方法も案内されています。
DifyのAgentナレッジベースの設定
Agentナレッジベース(ベータ版)は、分割や索引作りをDifyに任せる種類です。推論モデルが文書を読んで意味のまとまりで分け、セクションごとの要約と、チャンクに出てくる話題のつながり(ナレッジグラフ)を作ります。埋め込みモデルが、それを意味で検索できる形にします。「ナレッジ」で「Agent」に切り替えて「作成」から作ります。
自分で決める主な設定は「検索の深度」です。
| 検索の深度 | 動き | 向いている質問 |
|---|---|---|
| 高速(Fast) | 意味とキーワードで質問とチャンクを照合する。最も速い | ほとんどの直接的な質問。公式ドキュメントはここから始めることをすすめている |
| 詳細(Deep) | 高速より広く探し、ナレッジグラフをたどって関係する話題のチャンクも探す。高速より遅い | 答えが複数の関係する話題にまたがり、高速では見つからない質問 |
| リサーチ(Research) | 複雑な質問を小さな質問に分け、それぞれを広く探し、セクションの題と要約から読む箇所を決める。最も遅く、トークンも多く使う | 何回か検索しないと答えられない質問 |
Webサイトやオンラインドキュメントなどの取り込み元は、1時間から30日の間隔で自動的に同期できます。同期で変更が見つかると、その部分の索引が作り直され、トークンを消費します。アップロードするファイルは1つ15MBまでです。
検索結果の確認には、検索テストに加えて次の機能があります。
- 評価用の基準質問:よく聞かれる質問と、返ってくるべきチャンクを登録しておき、設定やモデルを変えるたびに「評価」でまとめて確認する
- 問題ケース:正しいチャンクが返らなかった質問を、「該当する内容が見つからない」「低スコア」などの理由付きで記録し、直したあとに再テストする。アプリの利用中に見つかった取りこぼしも記録される
ワークフローとチャットフローからは、「Agent ナレッジ検索(Agent Knowledge Retrieval)」ノードで検索します。このノードもベータ版で、1つのノードで10個までのナレッジベースを検索できます。資料に一致する内容が無い場合、ノードは空のresultを返して処理を続けます。資料に無い質問に答えさせたくない場合は、LLMノードの前に「If-Else」ノードを置き、resultが空かどうかで分岐させる方法が公式ドキュメントで案内されています。
回答の精度が低いときの見直し点
RAGの回答が資料と合わない原因は、「関係するチャンクが取り出せていない」か「取り出せているのに回答が合わない」かのどちらかです。まずナレッジの「検索テスト」で、利用者が入力しそうな質問を試し、どのチャンクが返るかを確認します。アプリの中では、知識検索ノードの「最後の実行」で、そのノードの入力と出力を確認できます。
| 起きていること | 最初に確認すること | 公式ドキュメントで案内されている見直し方 |
|---|---|---|
| 関係するチャンクが返らない | 文書のページでチャンクの中身を見る。短すぎて文脈が無い、長すぎて余計な内容が多い、文や段落の途中で切れている、のどれかが無いか | 区切り文字・最大チャンク長・オーバーラップを調整する。文脈が必要な文書は親子モードで作る。検索の範囲を広げる(TopKを上げる、Scoreしきい値を下げる)。ただし関係の薄いチャンクも増える |
| 型番や社内用語で探すと見つからない | 検索の方法がベクトル検索だけになっていないか | 全文検索かハイブリッド検索にする。重み付け設定でキーワードの比率を上げる |
| 言い換えや別の言語の質問で見つからない | インデックスがエコノミーになっていないか。検索の方法が全文検索だけになっていないか | 高品質のインデックスにして、ベクトル検索かハイブリッド検索で意味の比率を上げる。チャンクに、利用者の質問の言い方で書いた要約を付ける |
| 正しいチャンクは返るが順位が低い | リランクがオフになっていないか | Rerankモデルを有効にする。Agentナレッジベースでは、別のRerankモデルを試す |
| 関係のない文書から答えている | 検索の対象に、別の部署や地域の文書、改訂前の文書が入っていないか | メタデータを付けて手動モードで絞り込む。使わない文書やチャンクを無効にする。Scoreしきい値を上げる |
| チャンクは返るのに回答が合わない | LLMノードの「コンテキスト」に知識検索のresultが入っているか。指示文でコンテキストを参照しているか | LLMノードの指示やモデルを見直す。資料に無い質問への答え方を指示に書く |
設定は1つずつ変え、変えるたびに同じ質問で検索テストをやり直すと、どの変更が効いたかを比べられます。検索テストの画面で変えた検索の設定は、そのテストの間だけ使われ、ナレッジベースには保存されません。テストの記録は「記録」に残るので、変更の前後の結果を見比べられます。
チャンクの見直しには、次の方法も公式ドキュメントで紹介されています。
- チャンクの要約:要約も検索の対象になり、要約が一致すると元のチャンクが返る。資料が硬い言葉で書かれている、表やコードが中心で意味で探しにくい、といった場合に、利用者が質問する言い方で要約を書く
- 親子モードの子チャンクの書き換え:子チャンクを編集しても親チャンクは変わらない。子チャンクを、キーワードや「赤いランプが点灯したままのときは?」のような質問の形に書き換えて、検索の手がかりにする
- キーワードの追加:エコノミーのインデックスでは、チャンクごとに10個までキーワードを追加・編集できる
Difyのナレッジの上限と注意点
文書数・保存容量・リクエスト数の上限
2026年11月時点のDify Cloudの料金ページでは、無料のSandboxプランのナレッジは50文書・保存容量50MBまで、ナレッジへのリクエストは1分あたり10回までです。上限は、従来型とAgentの両方のナレッジベースで共有されます。
- 文書数:無効にした文書、アーカイブした文書、処理に失敗した文書も数に入る
- 保存容量:元のファイルの大きさではなく、索引にしたあとのチャンクの文章とベクトルの量で数える。従来型のエコノミーのインデックスは、保存容量に数えられない
- リクエスト数:従来型ナレッジベースでは、知識検索ノードが1回動くごとに1回と数える。反復処理やループの中に置くと、1周ごとに数えるため、件数の多い処理はそれだけで上限に届くことがある
リクエスト数の上限に届くと、次の要求は断られます。断られた要求も回数に数えられるため、すぐにやり直すと止まったままになります。公式ドキュメントでは、1分待ってからやり直すよう案内されています。プランごとの上限は「Difyの料金プラン」で説明しています。
使われない文書は自動で無効になる
従来型ナレッジベースでは、一定の期間、更新も検索もされない文書は自動的に無効になります。期間はSandboxが7日、ProfessionalとTeamが30日です。無効になった文書は検索の対象から外れるため、試しに作ったナレッジベースをしばらくあとに使うときは、文書の状態を確認してください。チャンクを手で追加する機能も、ProfessionalとTeamのみです。
モデルの変更や索引の作り直しにはトークンを使う
高品質のインデックス、埋め込みモデルの変更、Rerankモデルの利用、Agentナレッジベースの索引作りと同期、従来型からAgentへのアップグレードでは、モデルのトークンを消費します。公式ドキュメントでは、少数の代表的な文書で検索を調整してから残りの文書を追加することがすすめられています。
資料の内容はAIモデルの提供元へ送られる
外部のAIモデルを使う場合、質問と、ナレッジから取り出したチャンクの内容は、そのモデルの提供元へ送られます。埋め込みモデルやRerankモデルにも、文書の内容が送られます。社外に出せない資料を登録する場合は、使うモデルの提供元の利用規約で、送った内容の扱いを先に確認します。
DifyのRAG・ナレッジに関するよくある質問
DifyのRAGは無料で試せますか?
無料のSandboxプランでもナレッジは使えます(2026年11月時点、50文書・50MB、アップロードは1回1ファイル・15MBまで)。AIモデルの呼び出しにはクレジットを使い、Sandboxのクレジットは200の1回限りです。自分のサーバーでDifyを動かす方法は「Difyのセルフホスト方法」で説明しています。
チャンクのモードや検索の方法はあとから変えられますか?
チャンクのモード(汎用・親子)と取り込み元は、ナレッジベースを作ったあとに変更できません。インデックスは、エコノミーから高品質へは変更でき、高品質からエコノミーへは戻せません。区切り文字・最大チャンク長、埋め込みモデル、検索の方法、TopK・Scoreしきい値は、あとから変更できます。
従来型とAgent、どちらのナレッジベースを使えばよいですか?
ワークフローかチャットフローで使い、分割の細かな設定が不要なら、公式ドキュメントはAgentナレッジベースをすすめています。ただし2026年11月時点ではベータ版です。チャットボットなどの基本のアプリで使う場合、分割や検索の方法を自分で決めたい場合、外部ナレッジAPIを使う場合、15MBを超えるファイルを使う場合は、従来型ナレッジベースを使います。
まとめ
DifyのRAGは、ナレッジに登録した文書を検索し、その内容をAIモデルに渡して回答させる仕組みです。
- ナレッジベースは、設定を自分で決める従来型と、分割や索引作りをDifyに任せるAgent(ベータ版)の2種類
- 従来型では、チャンクのモード、インデックスの方法と埋め込みモデル、検索の方法、リランク、TopK・Scoreしきい値、メタデータを設定する。チャンクのモードは作成後に変えられない
- 自社の検索の仕組みは、外部ナレッジAPIの仕様に合わせたAPIを作れば、資料を移さずにつなげる
- 精度が低いときは、検索テストでチャンクが返るかを先に確認し、返らなければ分割・検索の設定、返るのに回答が合わなければLLMの指示を見直す
- Sandboxプランは50文書・50MB、ナレッジへのリクエストは1分あたり10回まで(2026年11月時点)
まずは少数の代表的な文書でナレッジベースを作り、検索テストで設定を1つずつ試してから、残りの文書を追加してください。Difyでできることの全体は「Difyとは?」、Dify・n8n・Zapierの違いは「AI自動化ツールの選び方」で紹介しています。